


 许可协议,未经允许,禁止用于商业用途。转载需注明出处(点击右侧按钮可直接复制Markdown格式的转载声明)。
3. JVM监控及诊断工具-GUI篇
3.1 工具概述
使用上一章命令行工具或组合能帮您获取目标Java应用性能相关的基础信息,但它们存在下列局限:
1.无法获取方法级别的分析数据,如方法间的调用关系、各方法的调用次数和调用时间等(这对定位应用性能瓶颈至关重要)。
2.要求用户登录到目标 Java 应用所在的宿主机上,使用起来不是很方便。
3.分析数据通过终端输出,结果展示不够直观。
为此,JDK提供了一些内存泄漏的分析工具,如jconsole,jvisualvm等,用于辅助开发人员定位问题,但是这些工具很多时候并不足以满足快速定位的需求。所以这里我们介绍的工具相对多一些、丰富一些。
图形化综合诊断工具
- JDK自带的工具
- jconsole:JDK 自带的可视化监控工具。查看 Java 应用程序的运行概况、监控堆信息、永久区(或元空间)使用情况、类加载情况等
- 位置:
<JAVA_HOME>\bin\jconsole.exe
- 位置:
- Visual VM:Visual VM 是一个工具,它提供了一个可视界面,用于查看 Java 虚拟机上运行的基于 Java 技术的应用程序的详细信息。
- 官网:https://visualvm.github.io/ ,默认情况下,JDK 不再带这个工具,需要自行下载
- JMC:Java Mission Control,内置 Java Flight Recorder。能够以极低的性能开销收集Java虚拟机的性能数据。
- jconsole:JDK 自带的可视化监控工具。查看 Java 应用程序的运行概况、监控堆信息、永久区(或元空间)使用情况、类加载情况等
- 第三方工具
- MAT:MAT(Memory Analyzer Tool)是基于 Eclipse 的内存分析工具,是一个快速、功能丰富的 Java heap 分析工具,它可以帮助我们查找内存泄漏和减少内存消耗
- Eclipse 的插件形式安装
- JProfiler:商业软件,需要付费。功能强大。
- MAT:MAT(Memory Analyzer Tool)是基于 Eclipse 的内存分析工具,是一个快速、功能丰富的 Java heap 分析工具,它可以帮助我们查找内存泄漏和减少内存消耗
3.2 JConsole
jconsole:从 Java 5 开始,在 JDK 中自带的 Java 监控和管理控制台。用于对 JVM 中内存、线程和类等的监控,是一个基于 JMX(java management extensions) 的 GUI 性能监控工具。
官方文档:https://docs.oracle.com/javase/7/docs/technotes/guides/management/jconsole.html
3.2.1 启动
两种启动方式:
- 直接单击
jconsole.exe,仅适用于 Windows - 命令行窗口中输入
jconsole命令
启动界面如下:

需要选择一个要监控的进程。
界面如下:


三种启动方式
- Local:使用 JConsole 连接一个正在本地系统运行的 JVM,并且执行程序的和运行 JConsole 的需要是同一个用户。JConsole 使用文件系统的授权通过 RMI 连接起链接到平台的 MBean 的服务器上。这种从本地连接的监控能力只有 Sun 的 JDK 具有。
- Remote:使用下面的 URL 通过 RMI 连接器连接到一个 JMX 代理,
service:jmx:rmi:///jndi/rmi://hostName:portNum/jmxrmi。JConsole 为建立连接,需要在环境变量中设置mx.remote.credentials来指定用户名和密码,从而进行授权。 - Advanced:使用一个特殊的 URL 连接 JMX 代理。一般情况使用自己定制的连接器而不是 RMI 提供的连接器来连接 JMX 代理,或者是一个使用 JDK1.4 的实现了 JMX 和 JMX Remote 的应用
3.3 Visual VM
- Visual VM是一个功能强大的多合一故障诊断和性能监控的可视化工具。
- 它集成了多个JDK命令行工具,使用Visual VM可用于显示虚拟机进程及进程的配置和环境信息(jps,jinfo),监视应用程序的CPU、GC、堆、方法区及线程的信息(jstat、jstack)等,甚至代替JConsole。
- 在JDK 6 Update 7以后,Visual VM便作为JDK的一部分发布(VisualVM 在JDK/bin目录下)即:它完全免费。
- 此外,Visual VM也可以作为独立的软件安装:官方地址:https://visualvm.github.io/index.html

3.3.1 插件的安装
IDEA 安装 VisualVM Launcher 插件
"File" "Settings" "Plugins" 打开插件安装界面。
在市场(Marketplace)中搜索 “VisualVM Launcher”

插件安装好之后,重启IDEA,然后再打开 "Settings" 配置界面,找到 "VisualVM Launcher",配置VisualVM的路径和JDK,如下:

3.3.2 连接方式
1. 在IDEA中通过插件启动

两种启动方式,一种是正常启动,一种是DEBUG启动。
也可启动应用后通过,左侧的 “Start VisualVM” 来启动。

启动后的界面如下:


2. 本地连接
进入到VisualVM安装目录,然后进入到 "bin" 文件夹,单击 "visualvm.exe" 启动 VisualVM。
界面如下

在左侧的“Local” 下双击要监控的进程。即可进入监控界面

3. 远程连接
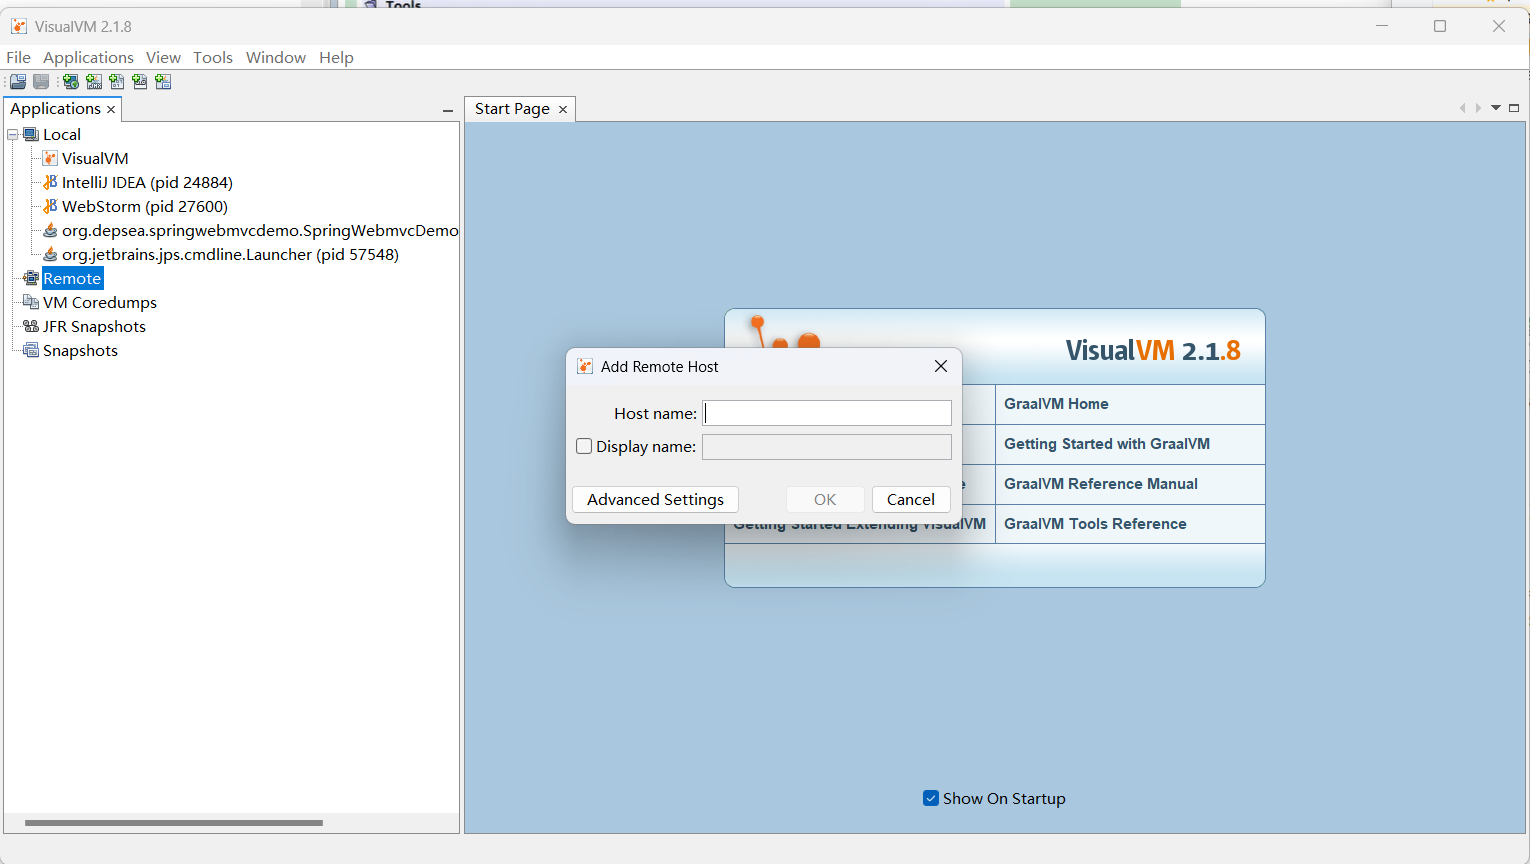
3.3.3 主要功能
- 生成/读取堆内存快照
- 查看JVM参数和系统属性
- 查看运行中的虚拟机进程
- 生成/读取线程快照
- 程序资源的实时监控
- 其他功能
- JMX代理连接
- 远程环境监控
- CPU分析和内存分析
生成堆内存/线程快照
在左侧的 “Local” 中通过进程生成堆内存/线程快照
在左侧的 “Local” 中右击要生成快照的进程
- 选择 “Heap Dump” 生成堆内存快照
- 选择 “Thread Dump” 生成线程快照

通过监视(Monitor)生成堆内存快照

堆内存快照如下:

这些快照存储在内存中,当线程停止的时候快照就会丢失,如果还想利用,可以将快照进行另存为操作,如下图:

通过线程(Threads)生成线程快照

线程快照如下:

这些快照存储在内存中,当线程停止的时候快照就会丢失,如果还想利用,可以将快照进行另存为操作,如下图:

载入堆内存/线程快照

通过 "File" "Load" 打开选择快照对话框。

选择堆内存快照或线程快照即可装入。
3.4 Eclipse MAT
3.4.1 概述
MAT(Memory Analyzer Tool)工具是一款功能强大的Java堆内存分析器。可以用于查找内存泄漏以及查看内存消耗情况。
MAT是基于Eclipse开发的,不仅可以单独使用,还可以作为插件的形式嵌入在Eclipse中使用。是一款免费的性能分析工具,使用起来非常方便。大家可以在 https://www.eclipse.org/mat/downloads.php 下载并使用MAT

只要确保机器上装有 JDK 并配置好相关的环境变量,MAT 可正常启动。还可以在 Eclipse 中以插件的方式安装。

3.4.2 获取堆dump文件
MAT可以分析heap dump文件。在进行内存分析时,只要获得了反映当前设备内存映像的hprof文件,通过MAT打开就可以直观地看到当前的内存信息。一般说来,这些内存信息包含:
- 所有的对象信息,包括对象实例、成员变量、存储于栈中的基本类型值和存储于堆中的其他对象的引用值。
- 所有的类信息,包括ClassLoader、类名称、父类、静态变量等
- GCRoot到所有的这些对象的引用路径
- 线程信息,包括线程的调用栈及此线程的线程局部变量(TLS)
MAT 不是一个万能工具,它并不能处理所有类型的堆存储文件。但是比较主流的厂家和格式,例如Sun,HP,SAP 所采用的 HPROF 二进制堆存储文件,以及 IBM的 PHD 堆存储文件等都能被很好的解析。
最吸引人的还是能够快速为开发人员生成内存泄漏报表,方便定位问题和分析问题。虽然MAT有如此强大的功能,但是内存分析也没有简单到一键完成的程度,很多内存问题还是需要我们从MAT展现给我们的信息当中通过经验和直觉来判断才能发现。

获取Dump文件
方式一:通过前一章介绍的jmap工具生成,可以生成任意一个 Java 进程的 dump 文件。
方式二:通过配置 JVM 参数生成
- 选项"
-XX:+HeapDumpOnOutOfMemoryError"或"-XX:+HeapDumpBeforeFullGC" - 选项"
-XX:HeapDumpPath"所代表的含义就是当程序出现0utOfMemory时,将会在相应的目录下 生成一份 dump 文件。如果不指定选项“-XX:HeapDumpPath" 则在当前目录下生成 dump 文件。
对比:考虑到生产环境中几乎不可能在线对其进行分析,大都是采用离线分析,因此使用 jmap+MAT 工具是最常见的组合。
方式三: 使用VisualVM可以导出堆dump文件
方式四: 使用MAT既可以打开一个已有的堆快照,也可以通过MAT直接从活动Java程序中导出堆快照。 该功能将借助jps列出当前正在运行的Java 进程,以供选择并获取快照。
3.4.3 分析堆 dump 文件

Histogram
展示了各个类的实例数目以及这些实例的 Shallow heap 或者 Retained heap 的总和

thread overview
- 查看系统中的Java线程
- 查看局部变量的信息
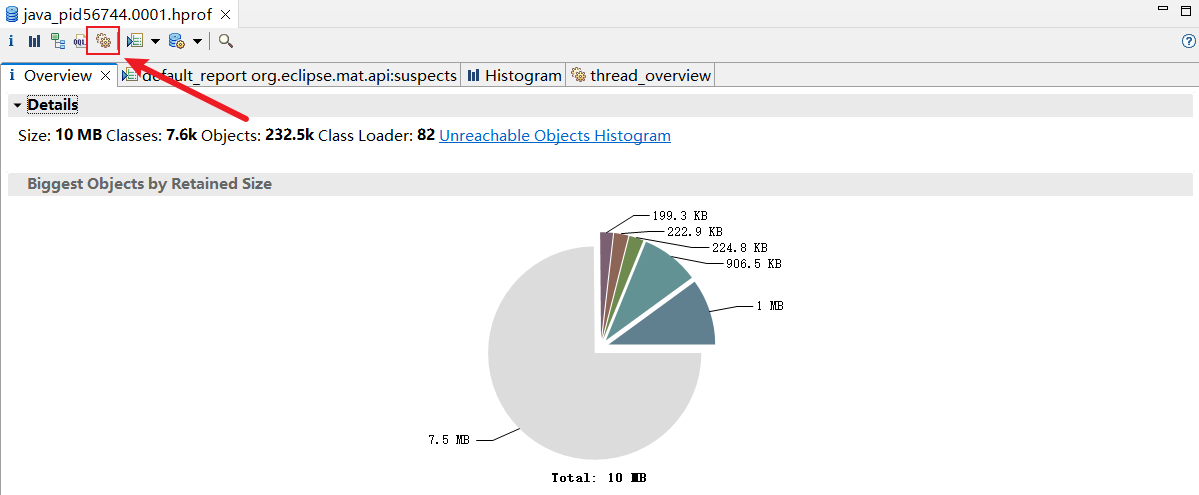

获取对象互相引用的关系
with outgoing references(对象的引出) 和 with incoming reference(对象的引入)

list objects

浅堆与深堆
MAT 计算对象占据内存的两种方式。shallow heap和retained heap。
浅堆(shallow heap)
浅堆 (Shallow Heap) 是指一个对象所消耗的内存。在 32 位系统中,一个对象引用会占据 4 个字节,一个 int 类型会占据 4 个字节,long 型变量会占据 8 个字节,每个对象头需要占用 8 个字节。根据堆快照格式不同,对象的大小可能会向 8 字节进行对齐。
以 String 为例: 2 个 int 值共占 8 字节,对象引用占用 4 字节,对象头 8 字节,合计 20 字节,向 8 字节对齐,故占 24 字节。(jdk7中)

这 24 字节为 String 对象的浅堆大小。它与 String 的 value 实际取值无关,无论字符串长度如何,浅堆大小始终是 24 字节。
深堆(retained heap)
保留集 (Retained Set):
对象A的保留集指当对象 A 被垃圾回收后,可以被释放的所有的对象集合(包括对象 A 本身),即对象A的保留集可以被认为是只能通过对象 A 被直接或间接访问到的所有对象的集合。通俗地说,就是指仅被对象 A 所持有的对象的集合。
深堆 (Retained Heap):
深堆是指对象的保留集中所有的对象的浅堆大小之和。
注意:浅堆指对象本身占用的内存,不包括其内部引用对象的大小。一个对象的深堆指只能通过该对象访问到的(直接或间接)所有对象的浅堆之和,即对象被回收后,可以释放的真实空间。
当前深堆大小 = 当前对象的浅堆大小 + 对象中所包含对象的深堆大小
补充:对象实际大小
另外一个常用的概念是对象的实际大小。这里,对象的实际大小定义为一个对象所能触及的所有对象的浅堆大小之和,也就是通常意义上我们说的对象大小。与深堆相比,似乎这个在日常开发中更为直观和被人接受,但实际上,这个概念和垃圾回收无关。
下图显示了一个简单的对象引用关系图,对象 A 引用了 C 和 D,对象 B 引用了 C 和 E。那么对象 A 的浅堆大小只是 A 本身,不含 C 和 D,而 A 的实际大小为 A、C、D 三者之和。而 A 的深堆大小为 A 与 D 之和,由于对象 C 还可以通过对象 B 访问到,因此不在对象 A 的深堆范围内。

练习
看图理解 Retained Size

上图中,GC Roots 直接引用了 A 和 B 两个对象
- A 对象的 Retained Size = A 对象的 Shallow Size
- B 对象的 Retained Size = B 对象的 Shallow Size + C 对象的 Shallow Size
这里不包括 D 对象, 因为 D 对象被 GC Roots 直接引用。
如果 GC Roots 不引用 D 对象呢?

案例分析
import java.util.ArrayList;
import java.util.List;

/**
 * 有一个学生浏览网页的记录程序,它将记录 每个学生访问过的网站地址。
 * 它由三个部分组成:Student、WebPage和StudentTrace三个类
 *
 *  -XX:+HeapDumpBeforeFullGC -XX:HeapDumpPath=c:\code\student.hprof
 */
public class StudentTrace {
    static List<WebPage> webpages = new ArrayList<WebPage>();

    public static void createWebPages() {
        for (int i = 0; i < 100; i++) {
            WebPage wp = new WebPage();
            wp.setUrl("http://www." + Integer.toString(i) + ".com");
            wp.setContent(Integer.toString(i));
            webpages.add(wp);
        }
    }

    public static void main(String[] args) {
        createWebPages();//创建了100个网页
        //创建3个学生对象
        Student st3 = new Student(3, "Tom");
        Student st5 = new Student(5, "Jerry");
        Student st7 = new Student(7, "Lily");

        for (int i = 0; i < webpages.size(); i++) {
            if (i % st3.getId() == 0)
                st3.visit(webpages.get(i));
            if (i % st5.getId() == 0)
                st5.visit(webpages.get(i));
            if (i % st7.getId() == 0)
                st7.visit(webpages.get(i));
        }
        webpages.clear();
        System.gc();
    }
}

class Student {
    private int id;
    private String name;
    private List<WebPage> history = new ArrayList<>();

    public Student(int id, String name) {
        super();
        this.id = id;
        this.name = name;
    }

    public int getId() {
        return id;
    }

    public void setId(int id) {
        this.id = id;
    }

    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public List<WebPage> getHistory() {
        return history;
    }

    public void setHistory(List<WebPage> history) {
        this.history = history;
    }

    public void visit(WebPage wp) {
        if (wp != null) {
            history.add(wp);
        }
    }
}


class WebPage {
    private String url;
    private String content;

    public String getUrl() {
        return url;
    }

    public void setUrl(String url) {
        this.url = url;
    }

    public String getContent() {
        return content;
    }

    public void setContent(String content) {
        this.content = content;
    }
}

结论:
elementData 数组的浅堆是 80 个字节,而 elementData 数组中的所有 WebPage 对象的深堆之和是 1208 个字节,所以加在一起就是 elementData 数组的深堆之和,也就是 1288 个字节
解释:
我说“elementData 数组的浅堆是 80 个字节”,其中 15 个对象一共是 60 个字节,对象头 8 个字节,数组对象本身 4 个字节,这些的和是 72 个字节,然后总和要是 8 的倍数,所以“elementData 数组的浅堆是 80 个字节”
我说“WebPage 对象的深堆之和是 1208 个字节”,一共有 15 个对象,其中 0、21、42、63、84、35、70 不仅仅是 7 的倍数,还是 3 或者 5 的倍数,所以这几个数值对应的 i 不能计算在深堆之内,这 15 个对象中大多数的深堆是 152 个字节,但是 i 是 0 和 7 的那两个深堆是 144 个字节,所以 (13152+1442)-(6*152+144)=1208,所以这也印证了我上面的话,即“WebPage 对象的深堆之和是 1208 个字节”
因此“elementData 数组的浅堆 80 个字节”加上“WebPage 对象的深堆之和 1208 个字节”,正好是 1288 个字节,说明“elementData 数组的浅堆 1288 个字节”
支配树
支配树的概念源自图论。
MAT 提供了一个称为支配树的对象图。支配树视图对数据进行了归类,体现了对象实例间的支配关系。在对象引用图中,所有指向对象 B 的路径都经过对象 A ,则认为对象 A 支配了对象 B。如果对象A时离对象 B 最近的一个支配对象,则认为对象 A 为对象 B 的直接支配者,支配树是基于对象间的引用图所建立的,它有以下基本性质:
- 对象 A 的子树(所有被对象 A 支配的对象集合)表示对象 A 的保留集(retained set),即深堆。
- 如果对象 A 支配对象 B,那么对象 A 的直接支配者也支配对象 B。
- 支配树的边与对象引用图的边不直接对应。
如下图所示:左图表示对象引用图,右图表示左图所对应的支配树。对象 A 和 B 由根对象直接支配,由于在到对象 C 的路径中,可以经过 A,也可以经过 B,因此对象 C 的直接支配者也是根对象。对象 F 与对象 D 相互引用,因为到对象 F 的所有路径必然经过对象 D,因此,对象 D 时对象 F 的直接支配者。而到对象 D 的所有路径中,必然经过对象 C,即使是从对象 F 到对象 D 的引用,从根节点触发,也是经过对象 C 的,所以,对象 D 的直接支配者为对象 C。

同理,对象 E 支配对象 G,支配关系是可传递的,因为 C 支配 E,所以 C 也支配 G。到达对象 H 可以通过对象 D,也可以通过对象 E,因此对象 D 和 E 都不能支配对象 H,而经过对象 C 既可以到达 D 也可以到达 E,因此对象 C 为对象 H 的直接支配者。
跟随我一起来理解如何从“对象引用图 支配树”,首先需要理解支配者(如果要到达对象 B,毕竟经过对象 A,那么对象 A 就是对象 B 的支配者,可以想到支配者大于等于 1),然后需要理解直接支配者(在支配者中距离对象 B 最近的对象 A 就是对象 B 的直接支配者,你要明白直接支配者不一定就是对象 B 的上一级,然后直接支配者只有一个),然后还需要理解支配树是怎么画的,其实支配树中的对象与对象之间的关系就是直接支配关系,也就是上一级是下一级的直接支配者,只要按照这样的方式来作图,肯定能从“对象引用图 支配树”
** 在 Eclipse MAT 工具中如何查看支配树:**
在 MAT 中,单击工具栏上的对象支配树按钮,可以打开对象支配树视图。

下图显示了对象支配树视图的一部分。该截图显示部分 Lily 学生的 history 队列的直接支配对象。即当 Lily 对象被回收,也会一并回收的所有对象。显然能被 3 或者 5 整除的网页不会出现在该列表中,因为它们同时被另外两名学生对象引用。
TODO 补充图片
3.4.4 案例:Tomcat 堆溢出分析
Tomcat 是最常用的 ]ava Servlet 容器之一,同时也可以当做单独的 Web 服务器使用。Tomcat 本身使用 Java 实现,并运行于 Java 虚拟机之上。在大规模请求时,Tomcat 有可能会因为无法承受压力而发生内存溢出错误。这里根据一个被压垮的 Tomcat 的堆快照文件,来分析 Tomcat 在崩溃时的内部情况。

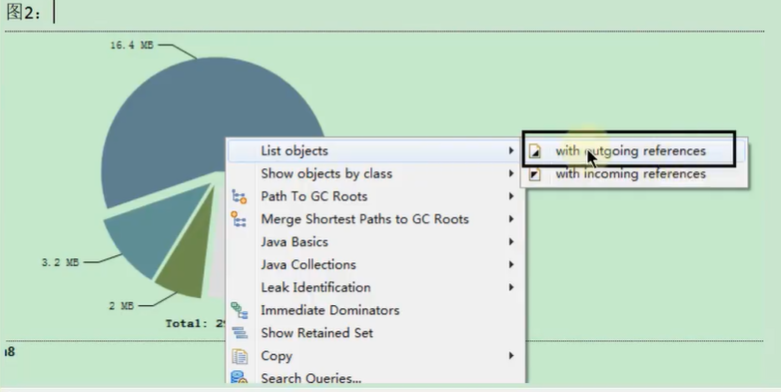
图 3:sessions 对象,它占用了约 17MB 空间。
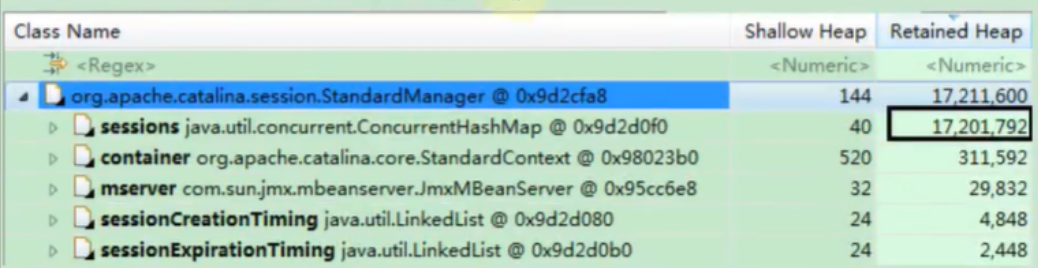
图 4: 可以看到 sessions 对象为 ConcurrentHashMap,其内部分为 16 个 Segment。从深堆大小看,每个 segment 都比较平均,大约为 1MB,合计 17MB。

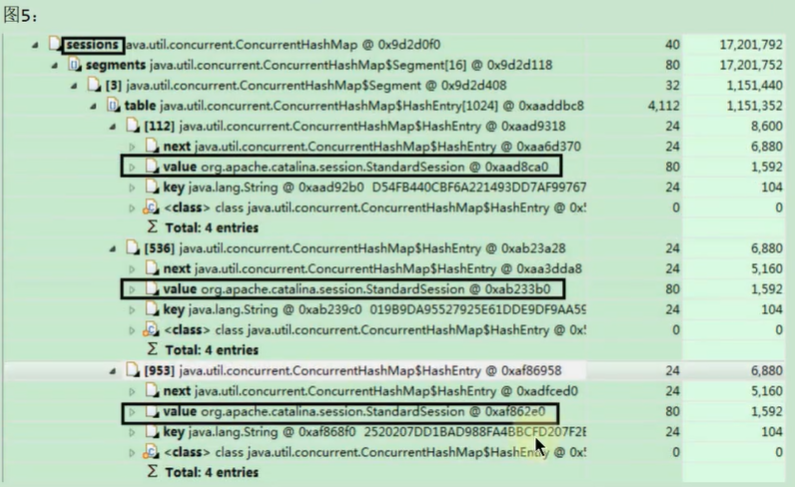
图 6: 当前堆中含有 9941 个 session,并且每一个 session 的深堆为 1592 字节,合计约 15MB,达到当前堆大小的 58%.


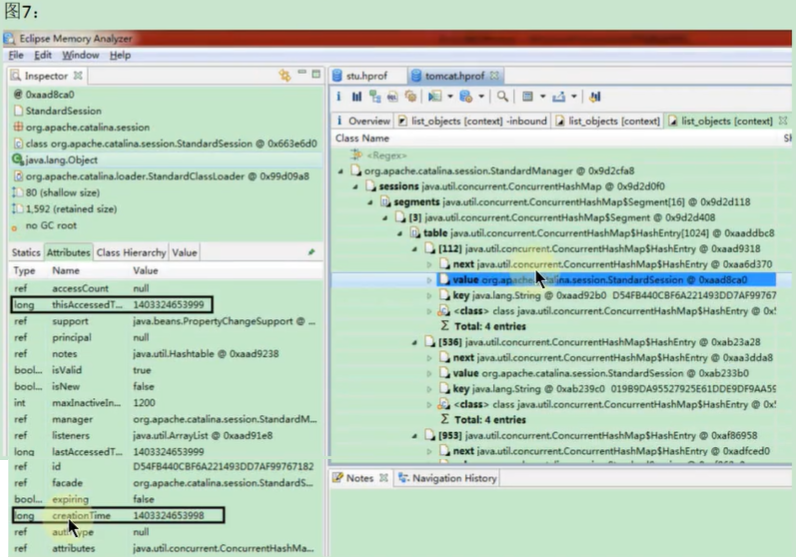
图8:

根据当前的 session 总数,可以计算每秒的平均压力为:9941/(1403324677648-1403324645728)*1800=311 次 / 秒。
由此推断,在发生 Tomcat 堆溢出时,Tomcat 在连续 38 秒的时间内,平均每秒接收了约 311 次不同客户端的请求,创建了合计 9941 个 session。
3.4.5 支持使用OQL语言查询对象信息
3.5 JProfiler
3.5.1 基本概述
在运行 Java 的时候有时候想测试运行时占用内存情况,这时候就需要使用测试工具查看了。在 eclipse 里面有 Eclipse Memory Analyzer tool(MAT)插件可以测试,而在 IDEA 中也有这么一个插件,就是 JProfiler。JProfiler 是由 ej-technologies 公司开发的一款 Java 应用性能诊断工具。功能强大,但是收费。
特点:
- 使用方便、界面操作友好(简单且强大)
- 对被分析的应用影响小(提供模板)
- CPU,Thread,Memory 分析功能尤其强大
- 支持对 jdbc,noSql,jsp,servlet,socket 等进行分析
- 支持多种模式(离线,在线)的分析
- 支持监控本地、远程的 JVM
- 跨平台,拥有多种操作系统的安装版本

主要功能:
- 方法调用:对方法调用的分析可以帮助您了解应用程序正在做什么,并找到提高其性能的方法
- 内存分配:通过分析堆上对象、引用链和垃圾收集能帮您修复内存泄露问题,优化内存使用
- 线程和锁:JProfiler 提供多种针对线程和锁的分析视图助您发现多线程问题
- 高级子系统:许多性能问题都发生在更高的语义级别上。例如,对于 JDBC 调用,您可能希望找出执行最慢的 SQL 语句。JProfiler 支持对这些子系统进行集成分析
官网地址:https://www.ej-technologies.com/products/jprofiler/overview.html
3.5.2 安装与配置
下载与安装
下载地址:https://www.ej-technologies.com/download/jprofiler/files

一个神秘的下载地址:https://downloadlynet.ir/2020/12/1885/03/jprofiler/00/
JProfiler 中配置 IDEA


3.5.3 具体使用
数据采集方式
Profier 数据采集方式分为两种:Sampling(样本采集)和 Instrumentation(重构模式)
- Instrumentation:这是 JProfiler 全功能模式。在 class 加载之前,JProfier 把相关功能代码写入到需要分析的 class 的 bytecode 中,对正在运行的 jvm 有一定影响。
- 优点:功能强大。在此设置中,调用堆栈信息是准确的。
- 缺点:若要分析的 class 较多,则对应用的性能影响较大,CPU 开销可能很高(取决于 Filter 的控制)。因此使用此模式一般配合 Filter 使用,只对特定的类或包进行分析
- Sampling:类似于样本统计,每隔一定时间(5ms)将每个线程栈中方法栈中的信息统计出来。
- 优点:对 CPU 的开销非常低,对应用影响小(即使你不配置任何 Filter)
- 缺点:一些数据/特性不能提供(例如:方法的调用次数、执行时间)
注:JProfiler 本身没有指出数据的采集类型,这里的采集类型是针对方法调用的采集类型。因为 JProfiler 的绝大多数核心功能都依赖方法调用采集的数据,所以可以直接认为是 JProfiler 的数据采集类型。
遥感监测 Telemetries
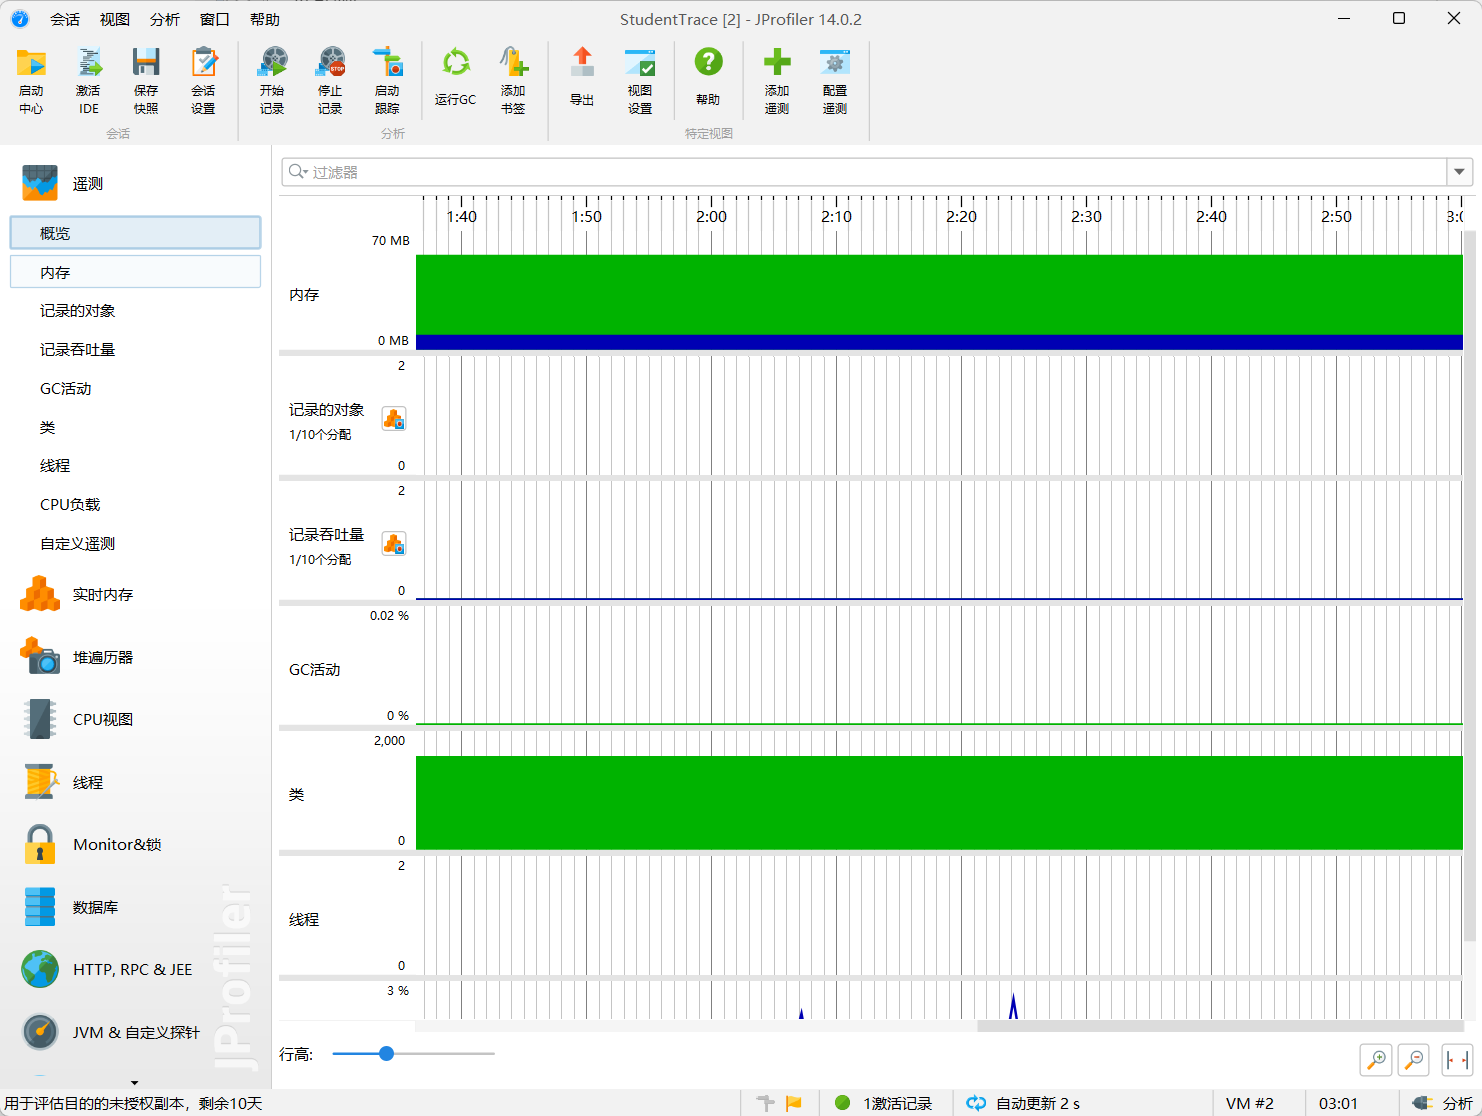
实时内存视图 (Live Memory)
Live memory 内存剖析:class/class instance 的相关信息。例如对象的个数,大小,对象创建的方法执行栈,对象创建的热点。

- 所有对象 All Objects
显示所有加载的类的列表和在堆上分配的实例数。只有 Java 1.5(JVMTI)才会显示此视图。 - 记录对象 Record Objects
查看特定时间段对象的分配,并记录分配的调用堆栈。 - 分配访问树 Allocation Call Tree
显示一棵请求树或者方法、类、包或对已选择类有带注释的分配信息的 J2EE 组件。 - 分配热点 Allocation Hot Spots
显示一个列表,包括方法、类、包或分配已选类的 J2EE 组件。你可以标注当前值并且显示差异值。对于每个热点都可以显示它的跟踪记录树。 - 类追踪器 Class Tracker
类跟踪视图可以包含任意数量的图表,显示选定的类和包的实例与时间。
分析:内存中的对象的情况
- 频繁创建的 Java 对象:死循环、循环次数过多
- 存在大的对象:读取文件是,
byte[]应该边读边写。 如果长时间不写出的话,导致byte[]过大 - 存在内存泄漏
- All Objects 后面的 Size 大小是浅堆大小
- Record Objects 在判断内存泄露的时候使用,可以通过观察 Telemetries 中的 Memory,如果里面出现垃圾回收之后的内存占用逐步提高,这就有可能出现内存泄露问题,所以可以使用 Record Objects 查看,但是该分析默认不开启,毕竟占用 CPU 性能太多
堆遍历器 (Heap Walker)


CPU 视图 (CPU Views)
JProfiler 提供不同的方法来记录访问树以优化性能和细节。线程或者线程组以及线程状况可以被所有的视图选择。所有的视图都可以聚集到方法、类、包或 J2EE 组件等不同层上。
- 访问树 Call Tree:显示一个积累的自顶向下的树,树中包含所有在 JVM 中已记录的访问队列。JDBC,JMS 和 JNDI 服务请求都被注释在请求树中。请求树可以根据 Servlet 和 JSP 对 URL 的不同需要进行拆分。
- 热点 Hot Spots:显示消耗时间最多的方法的列表。对每个热点都能够显示回溯树。该热点可以按照方法请求,JDBC,JMS 和 JNDI 服务请求以及按照 URL 请求来进行计算。
- 访问图 Call Graph:显示一个从已选方法、类、包或 J2EE 组件开始的访问队列的图。
- 方法统计 Method Statistics:显示一段时间内记录的方法的调用时间细节。

线程视图 (Threads)
JProfiler通过对线程历史的监控判断其运行状态,并监控是否有线程阻塞产生,还能将一个线程所管理的方法以树状形式呈现。对线程剖析。
- 线程历史 Thread History:显示一个与线程活动和线程状态在一起的活动时间表。
- 线程监控 Thread Monitor:显示一个列表,包括所有的活动线程以及它们目前的活动状况。
- 线程转储 Thread Dumps:显示所有线程的堆栈跟踪。
线程分析主要关心三个方面:
- web 容器的线程最大数。比如:Tomcat 的线程容量应该略大于最大并发数。
- 线程阻塞
- 线程死锁

监控和锁 (Monitors &Locks)
所有线程持有锁的情况以及锁的信息。观察 JVM 的内部线程并查看状态:
- 死锁探测图表 Current Locking Graph:显示 JVM 中的当前死锁图表。
- 目前使用的监测器 Current Monitors:显示目前使用的监测器并且包括它们的关联线程。
- 锁定历史图表 Locking History Graph:显示记录在 JVM 中的锁定历史。
- 历史检测记录 Monitor History:显示重大的等待事件和阻塞事件的历史记录。
- 监控器使用统计 Monitor Usage Statistics:显示分组监测,线程和监测类的统计监测数据
3.5.4 案例分析
案例1
import java.util.ArrayList;
import java.util.concurrent.TimeUnit;

public class JProfilerTest {
    public static void main(String[] args) {
        while (true) {
            ArrayList list = new ArrayList();
            for (int i = 0; i < 500; i++) {
                Data data = new Data();
                list.add(data);
            }
            try {
                TimeUnit.MILLISECONDS.sleep(500);
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        }
    }
}

class Data {
    private int size = 10;
    private byte[] buffer = new byte[1024 * 1024];//1mb
    private String info = "hello,atguigu";
}
案例2:
import java.util.ArrayList;
import java.util.concurrent.TimeUnit;

public class MemoryLeak {
    public static void main(String[] args) {
        while (true) {
            ArrayList beanList = new ArrayList();
            for (int i = 0; i < 500; i++) {
                Bean data = new Bean();
                data.list.add(new byte[1024 * 10]);//10kb
                beanList.add(data);
            }
            try {
                TimeUnit.MILLISECONDS.sleep(500);
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        }
    }

}

class Bean {
    int size = 10;
    String info = "hello,atguigu";
    static ArrayList list = new ArrayList();
}
3.6 Arthas
3.6.1 基本概述
背景
前面,我们介绍了 JDK 自带的 VisualVM 等免费工具,以及商业化工具 JProfiler。
这两款工具在业界知名度比较高,他们的优点是可以图形界面上看到各维度的性能数据,使用者根据这些数据进行综合分析,然后判断哪里出现了问题。
但是这两款工具也有个缺点,都必须在服务端项目进程中配置相关的监控参数。然后工具通过远程连接到项目进程,获取相关的数据。这样就会带来一些不便,比如线上环境的网络是隔离的,本地的监控工具根本连不上线上环境。并且类似于 JProfiler 这样的商业工具,是需要付费的。
那么有没有一款工具不需要远程连接,也不需要配置监控参数,同时也提供了丰富的性能监控数据呢?
阿里巴巴开源的性能分析神器 Arthas(阿尔萨斯) 应运而生。
概述
Arthas 是 Alibaba 开源的 Java 诊断工具,深受开发者喜爱。在线排查问题,无需重启;动态跟踪 Java 代码;实时监控 JVM 状态。
Arthas 支持 JDK 6+,支持 Linux/Mac/Windows,采用命令行交互模式,同时提供丰富的 Tab 自动补全功能,进一步方便进行问题的定位和诊断。当你遇到以下类似问题而束手无策时,Arthas 可以帮助你解决:
- 这个类从哪个 jar 包加载的?为什么会报各种类相关的 Exception?
- 我改的代码为什么没有执行到?难道是我没 commit?分支搞错了?
- 遇到问题无法在线上 Debug,难道只能通过加日志再重新发布吗?
- 线上遇到某个用户的数据处理有问题,但线上同样无法 Debug,线下无法重现!
- 是否有一个全局视角来查看系统的运行状况?
- 有什么办法可以监控到 JVM 的实时运行状态?
- 怎么快速定位应用的热点,生成火焰图?
Arthas 基于下列工具开发而来
- greys-anatomy: Arthas 代码基于 Greys 二次开发而来,非常感谢 Greys 之前所有的工作,以及 Greys 原作者对 Arthas 提出的意见和建议!
- termd: Arthas 的命令行实现基于 termd 开发,是一款优秀的命令行程序开发框架,感谢 termd 提供了优秀的框架。
- crash: Arthas 的文本渲染功能基于 crash 中的文本渲染功能开发,可以从这里看到源码,感谢 crash 在这方面所做的优秀工作。
- cli: Arthas 的命令行界面基于 vert.x 提供的 cli 库进行开发,感谢 vert.x 在这方面做的优秀工作。
- compiler Arthas 里的内存编绎器代码来源
- Apache Commons Net Arthas 里的 Telnet client 代码来源
- JavaAgent: 运行在 main 方法之前的拦截器,它内定的方法名叫 premain ,也就是说先执行 premain 方法然后再执行 main 方法
- ASM: 一个通用的 ]ava 字节码操作和分析框架。它可以用于修改现有的类或直接以二进制形式动态生成类。ASM 提供了一些常见的字节码转换和分析算法,可以从它们构建定制的复杂转换和代码分析工具。ASM 提供了与其他 Java 字节码框架类似的功能,但是主要关注性能。因为它被设计和实现得尽可能小和快,所以非常适合在动态系统中使用 (当然也可以以静态方式使用,例如在编译器中)
官方地址:https://arthas.aliyun.com/doc/quick-start.html
3.6.2 安装与使用
安装
安装方式一:
可以直接在Linux上通过命令下载
可以在官方 Github 上进行下载,如果速度较慢,可以尝试国内的码云 Gitee 下载。
- Github下载
wget https://alibaba.github.io/arthas/arthas-boot.jar - Gitee 下载
wget https://arthas.gitee.io/arthas-boot.jar
安装方式二:
也可以在浏览器直接访问 https://alibaba.github.io/arthas/arthas-boot.jar ,等待下载完后,上传到Linux服务器上。
卸载
在 Linux/Unix/Mac 平台,删除下面的文件:
rm -rf ~/.arthas
rm -rf ~/logs/arthas
Windows 平台直接删除 <User_Home> 下的 .arthas 和 logs/arthas 目录
工程目录
- arthas-agent: 基于 JavaAgent 技术的代理
- bin: 一些启动脚本
- arthas-boot: Java 版本的一键安装启动脚本
- arthas-client: telnet client 代码
- arthas-common: 一些共用的工具类和枚举类
- arthas-core: 核心库,各种 arthas 命令的交互和实现
- arthas-demo: 示例代码
- arthas-memorycompiler: 内存编绎器代码,Fork from https://github.com/skalogs/SkaETL/tree/master/compiler
- arthas-packaging: maven 打包相关的
- arthas-site: arthas 站点
- arthas-spy: 编织到目标类中的各个功面
- static: 静态资源
- arthas-testcase: 测试
启动
Arthas 只是一个 Java 程序,所以可以直接用 java -jar 运行。
执行成功后,arthas 提供了一种命令行方式的交互方式,arthas 会检测当前服务器上的 Java 进程并将进程列表展示出来,用户输入对应的编号 (1、2、3、4…) 进行选择,然后回车。
D:\Java>java -jar arthas-boot.jar
[INFO] JAVA_HOME: D:\Java\jdk-21.0.2
[INFO] arthas-boot version: 3.7.2
[INFO] Found existing java process, please choose one and input the serial number of the process, eg : 1. Then hit ENTER.
* [1]: 30816 jdk.jcmd/sun.tools.jcmd.JCmd
  [2]: 24884
  [3]: 43108
  [4]: 56744 org.depsea.springwebmvcdemo.SpringWebmvcDemoApplication
  [5]: 62156 org.depsea.springwebmvcdemo.StudentTrace
  [6]: 64220 D:\Program
D:\Java>java -jar arthas-boot.jar 56744
[INFO] JAVA_HOME: D:\Java\jdk-21.0.2
[INFO] arthas-boot version: 3.7.2
[INFO] Start download arthas from remote server: https://arthas.aliyun.com/download/3.7.2?mirror=aliyun
[INFO] Download arthas success.
[INFO] arthas home: C:\Users\Administrator\.arthas\lib\3.7.2\arthas
[INFO] Try to attach process 56744
Picked up JAVA_TOOL_OPTIONS:
[WARN] Current VM java version: 21 do not match target VM java version: 17, attach may fail.
[WARN] Target VM JAVA_HOME is D:\Java\jdk-17.0.8, arthas-boot JAVA_HOME is D:\Java\jdk-21.0.2, try to set the same JAVA_HOME.
[INFO] Attach process 56744 success.
[INFO] arthas-client connect 127.0.0.1 3658
  ,---.  ,------. ,--------.,--.  ,--.  ,---.   ,---.
 /  O  \ |  .--. ''--.  .--'|  '--'  | /  O  \ '   .-'
|  .-.  ||  '--'.'   |  |   |  .--.  ||  .-.  |`.  `-.
|  | |  ||  |\  \    |  |   |  |  |  ||  | |  |.-'    |
`--' `--'`--' '--'   `--'   `--'  `--'`--' `--'`-----'

wiki       https://arthas.aliyun.com/doc
tutorials  https://arthas.aliyun.com/doc/arthas-tutorials.html
version    3.7.2
main_class
pid        56744
time       2024-05-29 23:30:09
查看帮助
java -jar arghas-boot.jar -h
Web Console
除了在命令行查看外,Arthas 目前还支持 Web Console。在成功启动连接进程之后就已经自动启动,可以直接访问 http://127.0.0.1:8563/ 访问,页面上的操作模式和控制台完全一样。

退出
- 使用
quit/exit:退出当前客户端 - 使用
stop/shutdown:关闭 arthas 服务端,并退出所有客户端。
3.6.3 相关诊断指令
官方文档:https://arthas.aliyun.com/doc/commands.html
基础指令
help:查看命令帮助信息cat:打印文件内容,和 linux 里的 cat 命令类似echo:打印参数,和 linux 里的 echo 命令类似似grep:匹配查找,和 linux 里的 grep 命令类似tee:复制标准输入到标准输出和指定的文件,和 linux 里的 tee 命令类似pwd:返回当前的工作目录,和 linux 命令类似cls:清空当前屏幕区域session:查看当前会话的信息reset:重置增强类,将被 Arthas 增强过的类全部还原,Arthas 服务端关闭时会重置所有增强过的类version:输出当前目标 Java 进程所加戟的 Arthas 版本号history:打印命令历史quit:退出当前 Arthas 客户端,其他 Arthas 客户端不受影响stop:关闭 Arthas 服务端,所有 Arthas 客户端全部退出keymap:Arthas 快捷键列表及自定义快捷键
JVM 相关
dashboard: 当前系统的实时数据面板thread: 查看当前 JVM 的线程堆栈信息jvm: 查看当前 JVM 的信息sysenv: 查看 JVM 的环境变量sysprop: 查看和修改 JVM 的系统属性sysem: 查看 JVM 的环境变量vmoption: 查看和修改 JVM 里诊断相关的 optionperfcounter: 查看当前 JVM 的 Perf Counter 信息logger: 查看和修改 loggergetstatic: 查看类的静态属性ognl: 执行 ognl 表达式mbean: 查看 Mbean 的信息heapdump: dump java heap,类似 jmap 命令的 heap dump 功能
Class/ClassLoader 相关
sc: 查看 JVM 已加载的类信息sm: 查看已加载类的方法信息jad: 反编译指定已加载类的源码mc: 内存编译器,内存编译.java 文件为.class 文件retransform: 加载外部的.class 文件,retransform 到 JVM 里redefine: 加载外部的.class 文件,redefine 到 JVM 里dump: dump 已加载类的 byte code 到特定目录classloader: 查看 classloader 的继承树,urls,类加载信息,使用 classloader 去 getResource
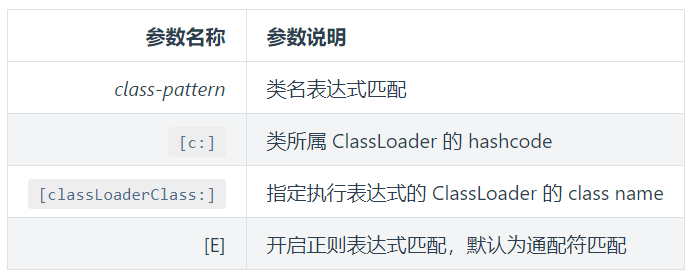
sc 命令
文档:https://arthas.aliyun.com/doc/sc.html
| 参数名称 | 参数说明 |
|---|---|
| class-pattern | 类名表达式匹配 |
| method-pattern | 方法名表达式匹配 |
| [d] | 输出当前类的详细信息,包括这个类所加载的原始文件来源、类的声明、加载的 ClassLoader 等详细信息。如果一个类被多个 ClassLoader 所加载,则会出现多次 |
| [E] | 开启正则表达式匹配,默认为通配符匹配 |
| [f] | 输出当前类的成员变量信息(需要配合参数-d 一起使用) |
| [x:] | 指定输出静态变量时属性的遍历深度,默认为 0,即直接使用 toString 输出 |
[c:] | 指定 class 的 ClassLoader 的 hashcode |
[classLoaderClass:] | 指定执行表达式的 ClassLoader 的 class name |
[n:] | 具有详细信息的匹配类的最大数量(默认为 100) |
[cs <arg>] | 指定 class 的 ClassLoader#toString() 返回值。长格式[classLoaderStr <arg>] |
class-pattern支持全限定名,如com.taobao.test.AAA,也支持com/taobao/test/AAA这样的格式,这样,我们从异常堆栈里面把类名拷贝过来的时候,不需要在手动把/替换为.啦。sc默认开启了子类匹配功能,也就是说所有当前类的子类也会被搜索出来,想要精确的匹配,请打开options disable-sub-class true开关
sm 命令
https://arthas.aliyun.com/doc/sm.html

jad 命令
https://arthas.aliyun.com/doc/jad.html
mc redefine 命令
classloader 命令
https://arthas.aliyun.com/doc/classloader.html

monitor/watch/trace 相关
- monitor 对匹配
class-pattern/method-pattern/condition-express的类、方法的调用进行监控。 - watch: 让你能方便的观察到指定函数的调用情况。能观察到的范围为:返回值、抛出异常、入参,通过编写 OGNL 表达式进行对应变量的查看。
- trace:
trace命令能主动搜索class-pattern/method-pattern对应的方法调用路径,渲染和统计整个调用链路上的所有性能开销和追踪调用链路。 - stack: 很多时候我们都知道一个方法被执行,但这个方法被执行的路径非常多,或者你根本就不知道这个方法是从那里被执行了,此时你需要的是
stack命令。 - tt: 方法执行数据的时空隧道,记录下指定方法每次调用的入参和返回信息,并能对这些不同的时间下调用进行观测
其他
- profiler/火焰图: https://arthas.aliyun.com/doc/profiler.html
- options: https://arthas.aliyun.com/doc/options.html
3.7 Java Mission Control
历史
在 Oracle 收购 Sun 之前,Oracle 的 JRockit 虚拟机提供了一款叫做 JRockit Mission Control 的虚拟机诊断工具。
在 Oracle 收购 sun 之后,Oracle 公司同时拥有了 Hotspot 和 JRockit 两款虚拟机。根据 Oracle 对于 Java 的战略,在今后的发展中,会将 JRokit 的优秀特性移植到 Hotspot 上。其中一个重要的改进就是在 Sun 的 JDK 中加入了 JRockit 的支持。
在 Oracle JDK 7u40 之后,Mission Control 这款工具己经绑定在 Oracle JDK 中发布。
自 Java11 开始,本节介绍的 JFR 己经开源。但在之前的 Java 版本,JFR 属于 Commercial Feature 通过 Java 虚拟机参数 -XX:+UnlockCommercialFeatures 开启。
- 官方地址:https://openjdk.org/projects/jmc
- Github项目地址:https://github.com/openjdk/jmc
概述
Java Mission Control(简称 JMC) , Java 官方提供的性能强劲的工具,是一个用于对 Java 应用程序进行管理、监视、概要分析和故障排除的工具套件。
它包含一个 GUI 客户端以及众多用来收集 Java 虚拟机性能数据的插件如 JMX Console(能够访问用来存放虚拟机齐个于系统运行数据的 MXBeans)以及虚拟机内置的高效 profiling 工具 Java Flight Recorder(JFR)。
JMC 的另一个优点就是:采用取样,而不是传统的代码植入技术,对应用性能的影响非常非常小,完全可以开着 JMC 来做压测(唯一影响可能是 full gc 多了)。
启动
Mission Control 位于 %JAVA_HOME%/bin/jmc.exe
功能:实时监控JVM运行时的状态
如果是远程服务器,使用前要开 JMX。
-Dcom.sun.management.jmxremote.port=${YOUR PORT}-Dcom.sun.management.jmxremote-Dcom.sun.management.jmxremote.authenticate=false-Dcom.sun.management.jmxremote.ssl=false-Djava.rmi.server.hostname=${YOUR HOST/IP}
文件 ->连接 ->创建新连接, 填入上面 JMX 参数的 host 和 port

Java Flight Recorder
Java Flight Recorder 是 JMC 的其中一个组件。
Java Flight Recorder 能够以极低的性能开销收集 Java 虚拟机的性能数据。
JFR 的性能开销很小,在默认配置下平均低于 1%。与其他工具相比,JFR 能够直接访问虚拟机内的数据,并且不会影响虚拟机的优化。因此,它非常适用于生产环境下满负荷运行的 Java 程序。
时间类型
Java Flight Recorder 和 JDK Mission Control 共同创建了一个完整的工具链。JDKMission Control 可对 Java Flight Recorder 连续收集低水平和详细的运行时信息进行高效详细的分析。
当启用时 JFR将记录运行过程中发生的一系列事件。其中包括Java层面的事件如线程事件、锁事件,以及Java虚拟机内部的事件,如新建对象,垃圾回收和即时编译事件。
按照发生时机以及持续时间来划分,JFR的事件共有四种类型,它们分别为以下四种:
- 瞬时事件(Instant Event) ,用户关心的是它们发生与否,例如异常、线程启动事件。
- 持续事件(Duration Event) ,用户关心的是它们的持续时间,例如垃圾回收事件。
- 计时事件(Timed Event) ,是时长超出指定阈值的持续事件。
- 取样事件(Sample Event),是周期性取样的事件。
取样事件的其中一个常见例子便是方法抽样(Method Sampling),即每隔一段时问统计各个线程的栈轨迹。如果在这些抽样取得的栈轨迹中存在一个反复出现的方法,那么我们可以推测该方法是热点方法
启动方式
方式1:使用 -XX:StartFlightRecording=参数
第一种是在运行目标 Java 程序时添加 -XX:startFlightRecording=参数。
比如: 下面命令中,JFR 将会在 Java 虚拟机启动 5s 后 (对应 delay=5s) 收集数据,持续 20s(对应 duration=28s)。当收集完毕后,JFR 会将收集得到的数据保存至指定的文件中(对应 filename=myrecording.jfr)
java -XX:StartFlightRecording=delay=5s,duration=20s,filename=myrecording.jfr,settings=profile MyApp
由于 JFR 将持续收集数据,如果不加以限制,那么 JFR 可能会填满硬盘的所有空间。因此,我们有必要对这种模式下所收集的数据进行限制。
比如:
java -XX:StartFlightRecording=maxage=10m,maxsize=100m,name=SomeLabel MyApp
方式2:使用 jcmd 的JFR.*子命令
通过jcmd来让 JFR 开始收集数据、停止收集数据,或者保存所收集的数据,对应的子命令分别为JFR.start, JFR.stop,以及JFR.dump。
$ jcmd <PID> JFR.start settings=profile maxage=10m maxsize=150m name=SomeLabel
上述命令运行过后,目标进程中的 JFR 已经开始收集数据。此时,我们可以通过下述命令来导出已经收集到的数据:
$ jcmd <PID> JFR.dump name=SomeLabel filename=myrecording.jfr
最后,我们可以通过下述命令关闭目标进程中的 JFR:
$ jcmd <PID> JFR.stop name=SomeLabel

1、启动飞行记录仪


2、正式启动


Java Flight Recorder 取样分析
要采用取样,必须先添加参数:
-XX:+UnlockCommercialFeatures-XX:+FlightRecorder
JDK9及更高版本
-XX:+UnlockCommercialFeatures-XX:+StartFlightRecording
如:-XX:+UnlockCommercialFeatures -XX:+FlightRecorder -XX:StartFlightRecording=duration=200s
否则:


第一张图片中的错误是最新版本中的错误,下面的图可能是一个早期版本中的错误
取样时间默认 1 分钟,可自行按需调整,事件设置选为profiling,然后可以设置取样 profile哪些信息,比如:
- 加上对象数量的统计: Java Virtual Machine Gc Detailed ObjectCount/Object Count after GC
- 方法调用采样的间隔从 10ms 改为 1ms(但不能低于 1ms,否则会影响性能了): JavaVirtual Machine Profiling Method Profiling Sample/Method SamplingInformation
- Socket 与 File 采样,10ms 太久,但即使改为 1ms 也未必能抓住什么,可以干脆取消掉:Java Application File Read/FileWrite/Socket Read/Socket Write

然后就开始 Profile,到时间后 Profile 结束,会自动把记录下载回来,在 JMC 中展示。

从展示信息中,我们大致可以读到内存和 CPU 信息、代码、线程和 IO 等比较重要的信息展示。
import java.util.ArrayList;
import java.util.Random;

public class OOMTest {
    public static void main(String[] args) {
        ArrayList<Picture> list = new ArrayList<>();
        while(true){
            try {
                Thread.sleep(5);
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            list.add(new Picture(new Random().nextInt(100 * 50)));
        }
    }
}

class Picture{
    private byte[] pixels;

    public Picture(int length) {
        this.pixels = new byte[length];
    }

    public byte[] getPixels() {
        return pixels;
    }

    public void setPixels(byte[] pixels) {
        this.pixels = pixels;
    }
}
3.8 其他工具
3.8.1 Flame Graphs(火焰图)
在追求极致性能的场景下,了解你的程序运行过程中cpu在干什么很重要,火焰图就是一种非常直观的展示CPU在程序整个生命周期过程中时间分配的工具。火焰图对于现代的程序员不应该陌生,这个工具可以非常直观的显示出调用找中的CPU消耗瓶颈。
网上的关于Java火焰图的讲解大部分来自于Brenden Gregg的博客 http://new.brendangregg.com/flamegraphs.html
CPU Flame Graphs

Memory Flame Graph

火焰图,简单通过x轴横条宽度来度量时间指标,y轴代表线程栈的层次。
3.8.2 Tprofiler
案例:
使用 JDK 自身提供的工具进行 JVM 调优可以将下 TPS 由 2.5 提升到 20(提升了 7 倍),并准确 定位系统瓶颈。
系统瓶颈有:应用里释态对象不是太多、有大量的业务线程在频繁创建一些生命周期很长的临时对象,代码里有问题。
那么,如何在海量业务代码里边准确定位这些性能代码?这里使用阿里开源工具 Tprofiler 来定位 这些性能代码,成功解决掉了 GC 过于频繁的性能瓶预,并最终在上次优化的基础上将 TPS 再提升了 4 倍,即提升到 100。
- Tprofiler 配置部署、远程操作、 日志阅谈都不太复杂,操作还是很简单的。但是其却是能够 起到一针见血、立竿见影的效果,帮我们解决了 GC 过于频繁的性能瓶预。
- Tprofiler 最重要的特性就是能够统汁出你指定时间段内 JVM 的 top method 这些 top method 极有可能就是造成你 JVM 性能瓶颈的元凶。这是其他大多数 JVM 调优工具所不具备的,包括 JRockit Mission Control。JRokit 首席开发者 Marcus Hirt 在其私人博客《 Lom Overhead Method Profiling cith Java Mission Control》下的评论中曾明确指出 JRMC 井不支持 TOP 方法的统计。
Github地址:http://github.com/alibaba/Tprofiler
3.8.3 Btrace
常见的动态追踪工具有BTrace、HouseHD(该项目己经停止开发)、Greys-Anatomy(国人开发 个人开发者)、Byteman(JBoss出品),注意Java运行时追踪工具井不限干这几种,但是这几个是相对比较常用的。
BTrace是SUN Kenai 云计算开发平台下的一个开源项目,旨在为java提供安全可靠的动态跟踪分析工具。先看一卜日Trace的官方定义:
BTrace is a safe, dynamic tracing tool for the Java platform. BTrace can be used to dynamically trace a running Java program(similar to DTrace for OpenSolaris applications and 0s). BTrace dynamically instruments the classes of the target application to inject tracing code (“bytecode tracing” ).
大概意思是一个 Java 平台的安全的动态追踪工具,可以用来动态地追踪一个运行的 Java 程序。BTrace动态调整目标应用程序的类以注入跟踪代码(“字节码跟踪“)。